Crawler-Abdeckung
99%
Anteil der Wörter aus dem gerenderten Haupttext, die auch der Crawler erhält.
https://metoz.de/
Der getrennt abgerufene Crawler-Text deckt den gerenderten Hauptinhalt nahezu vollständig ab.
Crawler-Abdeckung
99%
Anteil der Wörter aus dem gerenderten Haupttext, die auch der Crawler erhält.
Inhaltsähnlichkeit
99%
Vergleicht beide Texte unabhängig von reiner Wortzahl und erkennt gleich lange, aber andere Inhalte.
Wortdifferenz
+1 Wörter
0% gegenüber der gerenderten Ansicht. Minus heißt: dem Crawler fehlen Wörter.
Metoz-Score
76/100
40 % Crawler-Lesbarkeit, 20 % Zugang der Such- und Agenten-Bots, 40 % Beantwortbarkeit der sechs Zitat-Fragen.
Was jetzt?
Die Prompts enthalten Befund, Messdaten, Leitplanken und eine Abnahme per erneutem Scan von metoz.de – zum Einfügen in einen Coding-Agenten.
Befund: 4 von 6 Zitat-Fragen sind aus dem crawler-sichtbaren Text nicht oder nur teilweise beantwortbar: Zielgruppe, Preis, Standort, Unterschied zu Alternativen.
Folge: Such- und Antwortsysteme finden zu diesen Punkten keine belegbare Aussage auf der Seite und können sie nicht zuverlässig wiedergeben.
Empfehlung: Fehlende, fachlich bestätigte Angaben sichtbar und im initial ausgelieferten HTML ergänzen, nichts erfinden und anschließend erneut scannen.
Befund: 99% des gerenderten Haupttexts sind in der Crawler-Ansicht wiederzufinden.
Folge: Wichtige Aussagen sind nicht von JavaScript abhängig.
Empfehlung: Nach größeren Änderungen an Rendering oder CMS erneut scannen.
Befund: Keiner der geprüften Such-Crawler wird für diese URL durch robots.txt blockiert.
Folge: Die robots.txt verhindert damit nicht, dass diese Dienste die Seite als Webquelle abrufen.
Empfehlung: Bot-Regeln bei Änderungen an der robots.txt erneut prüfen.
Report mitnehmen
Wir schicken dir die wichtigsten Befunde und den Link zu diesem vollständigen Report.
Einmaliger Versand über Epostix, kein Newsletter und kein Öffnungs- oder Klicktracking. metoz.de speichert die E-Mail-Adresse nicht in der eigenen Datenbank. Mehr im Datenschutz.
Metoz-Werkstatt
Die Downloads entstehen nur in deinem Browser. Sie enthalten die beobachteten Befunde, klare Leitplanken und eine Abnahme per erneutem Scan – keine Garantie für Indexierung, Zitat oder Ranking.
Technik und Umsetzung
Übersetzt Empfehlungen, Messwerte und Bot-Sperren in einen neutralen Markdown-Auftrag mit Abnahmekriterien.
4 Antwortlücken
Übernimmt nur vollständig belegte Antworten. Fehlende Angaben bleiben als fachlicher Klärungsauftrag markiert.
Ein Modell hat ausschließlich den crawler-sichtbaren Text mit sechs immer gleichen Fragen geprüft. Das Ergebnis misst Beantwortbarkeit, nicht eine spätere Nennung in einem konkreten KI-Dienst.
Das Unternehmen Metoz
Beleg: „Metoz trennt deshalb Zugang, Lesbarkeit und Beantwortbarkeit – mit sichtbaren Belegen statt eines einzelnen Häkchens.“
Lässt sich aus dem crawler-sichtbaren Text nicht beantworten.
Lässt sich aus dem crawler-sichtbaren Text nicht beantworten.
Lässt sich aus dem crawler-sichtbaren Text nicht beantworten.
Per E-Mail
Beleg: „Kontakt: [email protected].“
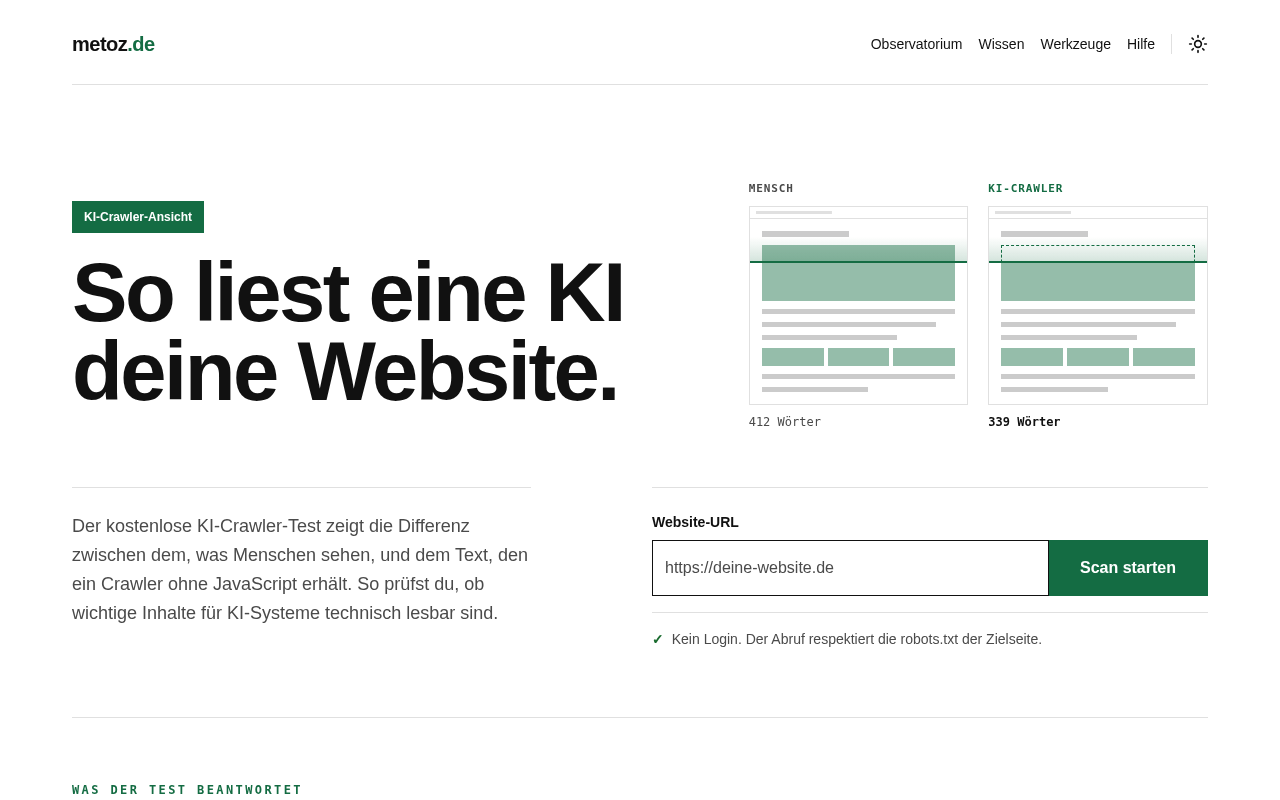
Durch den kostenlosen KI-Crawler-Test können wichtige Inhalte für KI-Systeme technisch lesbar sein.
Beleg: „So prüfst du, ob wichtige Inhalte für KI-Systeme technisch lesbar sind.“
Beide Ansichten werden getrennt abgerufen und anschließend mit derselben Haupttext-Extraktion ausgewertet. Kennzahlen und Grenzen erklärt.
Chromium mit JavaScript · 325 Wörter
metoz.deObservatoriumWissenWerkzeugeHilfeKI-Crawler-AnsichtDer kostenlose KI-Crawler-Test zeigt die Differenz zwischen dem, was Menschen sehen, und dem Text, den ein Crawler ohne JavaScript erhält. So prüfst du, ob wichtige Inhalte für KI-Systeme technisch lesbar sind.Website-URLKein Login. Der Abruf respektiert die robots.txt der Zielseite.Was der Test beantwortetAbrufbar ist nicht automatisch verständlich.Eine Website kann für einen Bot freigegeben sein und trotzdem kaum verwertbaren Text liefern. Metoz trennt deshalb Zugang, Lesbarkeit und Beantwortbarkeit – mit sichtbaren Belegen statt eines einzelnen Häkchens.01DoppelansichtBrowser mit JavaScript und MetozBot ohne JavaScript werden mit derselben Haupttext-Extraktion verglichen.02TürsteherDie robots.txt wird nach Suche, nutzergesteuerten Agentenabrufen und Training ausgewertet.03Zitat-TestSechs feste Fragen zeigen, welche Kernaussagen allein aus dem crawler-sichtbaren Text belegbar sind.Vom Befund zur ÄnderungKonkrete Arbeitsunterlagen statt einer weiteren Checkliste.Nach dem Scan erzeugt die Metoz-Werkstatt einen belegten Arbeitsauftrag für Entwickler oder Coding-Agenten. Zusätzlich helfen eigenständige Werkzeuge bei robots.txt-Regeln und fehlenden Website-Aussagen.01KI-Arbeitsauftrag aus dem ScanEmpfehlungen, Messwerte, Leitplanken und Abnahme als Markdown.02robots.txt für KI-BotsSuche, Agentenabrufe und Training getrennt konfigurieren.03Content-BriefingBestätigte Kernaussagen sammeln, ohne fehlende Fakten zu erfinden.WerkzeugeMetoz-Observatorium353 deutsche Websites, jeden Monat gleich gemessen.Das Observatorium macht aus Einzelbeobachtungen eine offene Zeitreihe: Behörden, DAX und MDAX, Nachrichtenseiten und Onlineshops. Rohdaten, CSV und Parquet erscheinen unter CC BY 4.0.Observatorium ansehen353Domains im Korpus4Segmentemonatlichfester RhythmusCC BYoffene LizenzKI-Crawler-Sichtbarkeit verstehenTechnische Grundlagen und konkrete Korrekturwege – sachlich, offen und ohne Rankingversprechen.Häufige FragenWas prüft Metoz?Metoz vergleicht den gerenderten Haupttext einer Website mit dem Text eines gekennzeichneten Crawlers ohne JavaScript. Zusätzlich werden robots.txt-Regeln für KI-Bots und sechs feste Fragen zur Zitierfähigkeit geprüft.Ist Metoz ein vollständiger SEO-Audit?Nein. Der Scan beantwortet gezielt, was ein KI-Crawler lesen darf und tatsächlich als Haupttext erhält. Rankings, Backlinks, interne Sucharchitektur und viele klassische SEO-Faktoren sind nicht Gegenstand des Tests.Werden Scan-Seiten von Suchmaschinen indexiert?Neue Scan-Permalinks bleiben standardmäßig auf noindex. Eine Freigabe erfolgt nur nach mehreren unabhängigen Anfragen. Korpusmessungen erscheinen als offener Datensatz und in neutralen Segmentlisten; ihre direkt erreichbaren Einzelansichten bleiben noindex.Respektiert Metoz die robots.txt?Ja. MetozBot identifiziert sich eindeutig, prüft die robots.txt und bricht den Crawler-Abruf ab, wenn die Zielseite ihn sperrt.Messmethode, Grenzen und Korrekturweg sind vollständig unter Methodik. Kontakt: [email protected].
Ohne JavaScript · 326 Wörter
metoz.deObservatoriumWissenWerkzeugeHilfeKI-Crawler-AnsichtDer kostenlose KI-Crawler-Test zeigt die Differenz zwischen dem, was Menschen sehen, und dem Text, den ein Crawler ohne JavaScript erhält. So prüfst du, ob wichtige Inhalte für KI-Systeme technisch lesbar sind.Website-URLKein Login. Der Abruf respektiert die robots.txt der Zielseite.Was der Test beantwortetAbrufbar ist nicht automatisch verständlich.Eine Website kann für einen Bot freigegeben sein und trotzdem kaum verwertbaren Text liefern. Metoz trennt deshalb Zugang, Lesbarkeit und Beantwortbarkeit – mit sichtbaren Belegen statt eines einzelnen Häkchens.01DoppelansichtBrowser mit JavaScript und MetozBot ohne JavaScript werden mit derselben Haupttext-Extraktion verglichen.02TürsteherDie robots.txt wird nach Suche, nutzergesteuerten Agentenabrufen und Training ausgewertet.03Zitat-TestSechs feste Fragen zeigen, welche Kernaussagen allein aus dem crawler-sichtbaren Text belegbar sind.Vom Befund zur ÄnderungKonkrete Arbeitsunterlagen statt einer weiteren Checkliste.Nach dem Scan erzeugt die Metoz-Werkstatt einen belegten Arbeitsauftrag für Entwickler oder Coding-Agenten. Zusätzlich helfen eigenständige Werkzeuge bei robots.txt-Regeln und fehlenden Website-Aussagen.01KI-Arbeitsauftrag aus dem ScanEmpfehlungen, Messwerte, Leitplanken und Abnahme als Markdown.02robots.txt für KI-BotsSuche, Agentenabrufe und Training getrennt konfigurieren.03Content-BriefingBestätigte Kernaussagen sammeln, ohne fehlende Fakten zu erfinden.WerkzeugeMetoz-Observatorium353 deutsche Websites, jeden Monat gleich gemessen.Das Observatorium macht aus Einzelbeobachtungen eine offene Zeitreihe: Behörden, DAX und MDAX, Nachrichtenseiten und Onlineshops. Rohdaten, CSV und Parquet erscheinen unter CC BY 4.0.Observatorium ansehen353Domains im Korpus4Segmentemonatlichfester RhythmusCC BYoffene LizenzKI-Crawler-Sichtbarkeit verstehenTechnische Grundlagen und konkrete Korrekturwege – sachlich, offen und ohne Rankingversprechen.Häufige FragenWas prüft Metoz?Metoz vergleicht den gerenderten Haupttext einer Website mit dem Text eines gekennzeichneten Crawlers ohne JavaScript. Zusätzlich werden robots.txt-Regeln für KI-Bots und sechs feste Fragen zur Zitierfähigkeit geprüft.Ist Metoz ein vollständiger SEO-Audit?Nein. Der Scan beantwortet gezielt, was ein KI-Crawler lesen darf und tatsächlich als Haupttext erhält. Rankings, Backlinks, interne Sucharchitektur und viele klassische SEO-Faktoren sind nicht Gegenstand des Tests.Werden Scan-Seiten von Suchmaschinen indexiert?Neue Scan-Permalinks bleiben standardmäßig auf noindex. Eine Freigabe erfolgt nur nach mehreren unabhängigen Anfragen. Korpusmessungen erscheinen als offener Datensatz und in neutralen Segmentlisten; ihre direkt erreichbaren Einzelansichten bleiben noindex.Respektiert Metoz die robots.txt?Ja. MetozBot identifiziert sich eindeutig, prüft die robots.txt und bricht den Crawler-Abruf ab, wenn die Zielseite ihn sperrt.Messmethode, Grenzen und Korrekturweg sind vollständig unter Methodik. Kontakt: [email protected].
robots.txt regelt den erlaubten Zugriff. Ein „erlaubt“ beweist noch nicht, dass ein Dienst die Seite indexiert oder zitiert.
Ohne Zugriff kann ChatGPT die Seite nicht als Quelle für die Websuche nennen.
Ohne Zugriff kann Claude die Seite nicht über diesen Such-Crawler als Quelle erfassen.
Ohne Zugriff kann die Seite in der Google-Suche fehlen; das ist keine reine KI-Einstellung.
Ohne Zugriff kann Perplexity die Seite nicht für seine Suchantworten indexieren.
Ohne Zugriff kann die Sichtbarkeit in Apple-Suchergebnissen eingeschränkt sein.
Ohne Zugriff können Metas Abrufdienste die Seite nicht in ihren Produkten aufbereiten.
Ohne Zugriff kann You.com die Seite nicht über diesen Such-Crawler erfassen.
Ohne Zugriff kann ChatGPT keine vom Nutzer ausgelösten Abrufe der Seite durchführen.
Ohne Zugriff sind von Claude-Nutzern ausgelöste Abrufe eingeschränkt.
Ohne Zugriff sind nutzergesteuerte Abrufe durch Perplexity eingeschränkt.
Ohne Zugriff sind externe, von Meta ausgelöste Abrufe eingeschränkt.
Ohne Zugriff fließt der Inhalt nicht in das Training von OpenAI-Modellen ein.
Ohne Zugriff kann Anthropic den Inhalt nicht mit diesem Crawler erfassen.
Ohne Zugriff darf Google den Inhalt nicht zur Verbesserung von Gemini und ähnlichen generativen APIs verwenden.
Ohne Zugriff kann Amazon den Inhalt nicht mit diesem KI-Crawler erfassen.
Ohne Zugriff kann Apple den Inhalt nicht für Apple-Intelligence-Dienste verwenden.
Ohne Zugriff erscheint der Inhalt nicht im Common-Crawl-Datensatz, den viele Modelle nutzen.
Ohne Zugriff kann Meta den Inhalt nicht über diesen externen Agenten abrufen.
Ohne Zugriff kann ByteDance den Inhalt nicht mit diesem Crawler erfassen.
Ohne Zugriff kann Cohere den Inhalt nicht mit diesem Crawler erfassen.
Ohne Zugriff kann Diffbot die Seite nicht für seine Wissensdaten erfassen.
robots.txt: gefunden und ausgewertet
Die gerenderte Ansicht läuft in Chromium mit JavaScript und einem normalen Browser-User-Agent. Die Crawler-Ansicht nutzt einen separaten Abruf mit MetozBot/1.0 und führt kein JavaScript aus. Beide HTML-Fassungen durchlaufen Mozilla Readability.
Gleiche Wortzahlen sind deshalb möglich und meist positiv. Aussagekräftiger sind Crawler-Abdeckung, Inhaltsähnlichkeit und die abweichenden Passagen. A/B-Tests, Consent-Banner und zeitabhängige Inhalte können zwei Abrufe trotzdem beeinflussen.
Modell im Zitat-Test: @cf/meta/llama-3.1-8b-instruct-fast